1. AI Agent 是什么
在本教程的范围内,AI Agent 是以大模型为决策组件、能调用工具并利用执行反馈推进任务的程序。
例如,用户要求“保存一条学习笔记,再读出来确认”。模型理解意图并选择动作;程序实际写入文件、读取文件;模型根据读回的结果再回答。这里真正带来可靠性的,是工具执行结果,而不是模型的一句“已完成”。
| 方式 | 谁决定步骤 | 适用场景 |
|---|---|---|
| 普通模型问答 | 通常一次生成答案 | 解释、改写、总结 |
| 固定脚本或工作流 | 开发者预先规定分支 | 输入稳定、规则明确、可重复 |
| AI Agent | 模型在程序许可范围内结合上下文与反馈选下一步 | 路径不固定,需要理解与工具选择 |
这是工程上的连续谱,不是严格分类。固定工作流可以包含模型节点,Agent 也可以嵌在确定的业务流程中。若步骤清楚且不会变化,脚本通常更便宜、更稳定;只有理解与判断构成瓶颈时,才值得让模型参与决策。
2. 最小闭环:目标、状态、动作与反馈
最小 Agent 可写成:LLM + Context / State + Tools + Loop。
| 组成 | 职责 | 一个最小实现中的形式 |
|---|---|---|
| 模型 | 理解请求,生成回答或工具调用 | 支持 tool calling 的模型 API |
| 上下文与状态 | 记录目标、此前对话和工具结果 | 内存中的 history 消息列表 |
| 工具 | 执行真实动作 | 时间、计算、保存笔记、读取笔记 |
| 循环 | 请求模型、分发工具、写回结果、决定停止 | run_turn() 一类函数 |
目标、工具权限、预算和停止条件贯穿这四部分。提示词可以说明规则,但不能替代程序层的权限校验。
模型输出最终文字只是本轮循环的停止信号,不自动等于业务目标完成。是否成功应由文件内容、计算结果或其他独立证据确认。
Tool Calling 到底发生了什么
开发者提供工具名、用途和参数结构。模型选择工具后返回结构化数据:
{
  "id": "call_1",
  "type": "function",
  "function": {
    "name": "save_note",
    "arguments": "{\"title\":\"学习计划\",\"content\":\"明天研究 Agent Loop\"}"
  }
}
arguments 本身是 JSON 字符串,需要程序解析。执行器随后检查:工具是否已注册、字段是否完整、类型是否正确、访问范围是否允许。检查通过才会调用 Python 函数。工具结果以 role: tool 与对应的 tool_call_id 回传给模型,让它决定下一步。
工具说明不等于工具实现;模型说完成,也不等于工具真的成功。
State 不是“模型学会了”
多轮能力来自每次重新发送消息历史,并没有训练模型或修改权重。对话历史在内存中,程序退出或 /clear 后会清空;笔记文件可以持久存在,却要经由读取工具才会重新进入模型上下文。长期记忆则还需要持久化、检索、选择与更新机制。
历史越长,请求数据与成本通常越多。长期运行时再设计摘要、裁剪和检索,通常比一开始加入向量数据库更合理。
3. 架构:本地执行,远程推理
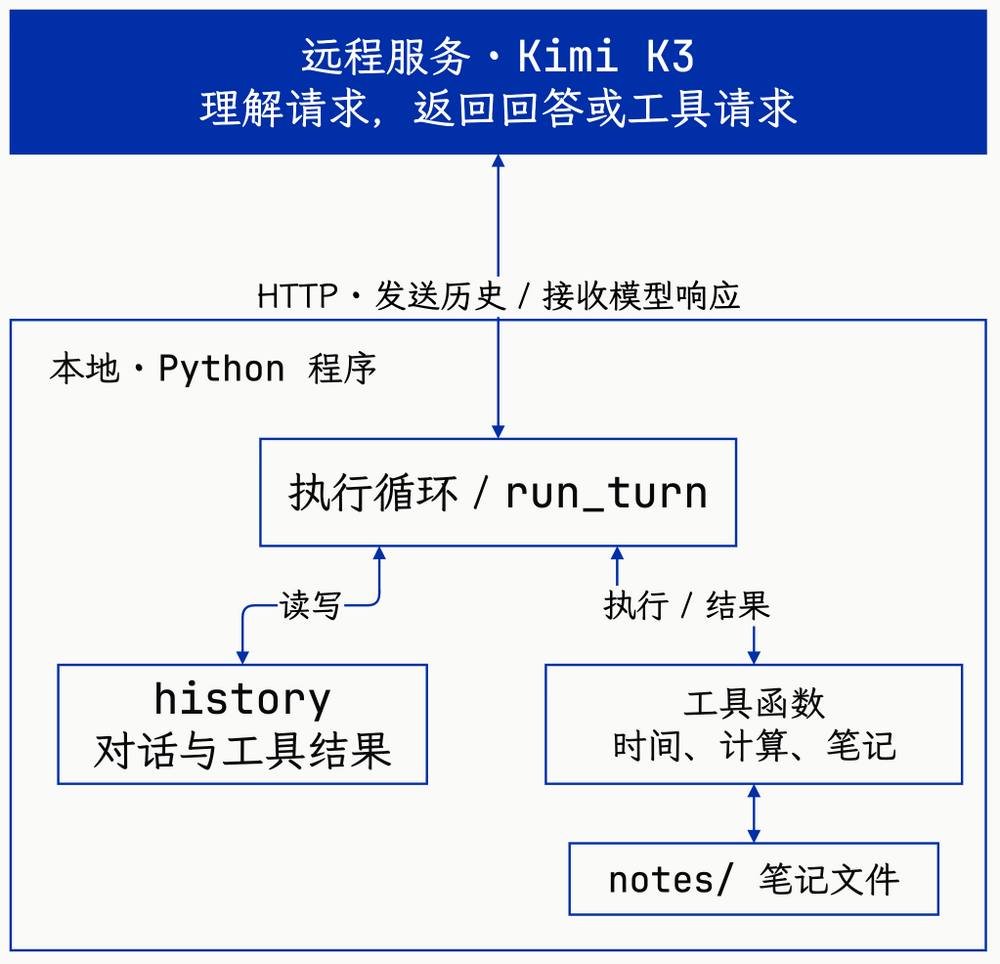
程序、文件和工具在本地环境运行;模型推理在远程服务完成。因此,工具参数、读出的笔记和工具返回数据可能会发送给配置的模型服务。这种架构便于使用云端模型,但应按数据敏感性设计工具权限与内容范围。
保存再读取的时序
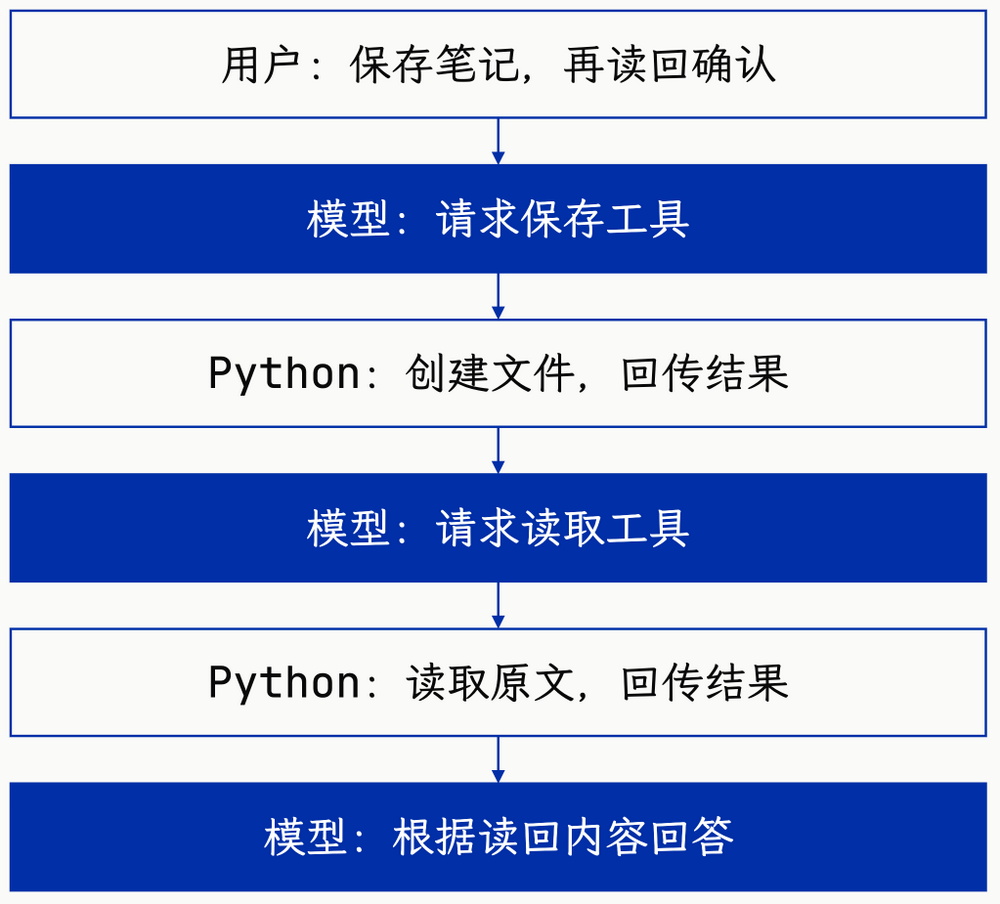
这是示意路径,不承诺每次调用的顺序或次数完全相同。模型可能在一个响应中请求多个工具;最小实现可按返回顺序串行执行,以便容易观察和排错。
4. 为什么先手写循环
框架能减少工具定义、类型校验和运行协调的重复代码,但也会把关键过程封装起来。对于有基础 Python 的学习者,先手写一个最小循环能看清消息、工具分发和反馈如何接上;理解后再依据复杂度选择框架。
| 方案 | 好处 | 代价 |
|---|---|---|
| 使用 Agent 框架 | 少写协议、校验和协调代码 | 初学时关键过程隐藏在抽象后 |
| 手写最小循环 | 清楚看到消息和工具的来回 | 要处理协议、异常与预算 |
框架不是模型,也不提供模型服务凭据。它解决的是工程组织问题,不能替代对闭环的理解。
5. 从零开发:七个步骤
1. 定义可验收的小目标
先写出“成功是什么”:查询真实时间、正确计算表达式、创建笔记并读回原文。避免从“做一个全能助手”开始。
2. 核实模型接入
确认模型 ID、Base URL、认证方式及工具调用支持;再确认凭据来自哪个产品。相同品牌的订阅凭据和开放平台凭据不一定可以互换。
3. 先实现普通 Python 工具
每个工具脱离模型也能运行,且有清晰输入、输出和错误反馈。保存工具要决定是否允许覆盖;读取工具应限制访问范围和大小。
4. 提供工具定义,并在本地校验
JSON Schema 告诉模型如何调用,但不能替代本地校验。只从固定函数映射表分发,绝不执行模型任意指定的代码。
5. 写 Agent Loop
下面是教学伪代码,需要补齐模型适配、工具实现和异常校验后才能运行。
history.append({"role": "user", "content": user_input})

for step in range(max_requests):
    message = model.complete(history)
    history.append(message)

    calls = message.get("tool_calls") or []
    if not calls:
        return message.get("content")

    for call in calls:
        result = execute_tool(call, functions)
        history.append({
            "role": "tool",
            "tool_call_id": call["id"],
            "content": json.dumps(result, ensure_ascii=False),
        })

raise AgentError("达到本轮请求上限")
关键顺序是:先保存模型提出的工具请求消息,再保存与之关联的工具结果,随后带着更新后的历史继续请求。
6. 设置异常与停止行为
处理网络失败、参数错误、未知工具、文件不存在、输出截断和预算耗尽。工具错误作为结构化结果回传;网络错误应明确终止本轮。已经产生的写入操作不会因模型随后失败而自动撤销。
7. 分层验证
| 验证层 | 核对内容 |
|---|---|
| 工具层 | 运算正确、文件读写正确、非法路径和参数被拒绝 |
| 协议层 | 工具请求与结果 ID 匹配,完整消息回传,多轮历史有效 |
| 循环层 | 能继续调用,也能在上限处停止 |
| 真实模型层 | 模型确实调用工具,结果可由磁盘或数据独立确认 |
模拟测试验证程序行为;真实 API 测试验证当前账户、模型和程序在当时能配合工作。两者不能互相替代。
6. 工具设计:能力与边界一起交付
一个最小学习型 Agent 可有四个工具:
| 工具 | 实际行为与边界 |
|---|---|
get_current_time |
查询执行环境的当前日期、时间和时区 |
calculate |
解析数学 AST,不使用任意 eval;限制长度、节点数、指数和数值范围 |
save_note |
在允许的笔记目录创建文件;默认不覆盖;正文有大小上限 |
read_note |
按标题读回笔记;限制路径、符号链接与文件大小 |
单轮请求上限和一次响应中的工具调用数量要分别限制。应用层校验能显著减少误操作,但不等于操作系统级沙箱;涉及高风险系统时仍需要最小权限、隔离环境和审计。
7. 模型配置:以 2026-09-14 实测为准
以下是作者在 2026-09-14 的一次接入核对,作为学习示例,并非对所有会员、所有账户或未来政策的承诺。使用前应以官方文档和账户页面为准。
| 项目 | Kimi Code 订阅接入 | Kimi 开放平台 |
|---|---|---|
| Base URL | https://api.kimi.com/coding/v1 |
https://api.moonshot.cn/v1 |
| K3 模型 ID | k3 |
kimi-k3 |
| 凭据来源 | Kimi Code 控制台 | 开放平台控制台 |
| 额度体系 | 订阅权益 | 按量计费余额 |
示例配置中不要保存或提交真实 Key:
LLM_API_KEY=仅在本地安全保存
LLM_BASE_URL=https://api.kimi.com/coding/v1
LLM_MODEL=k3
LLM_TIMEOUT_SECONDS=120
AGENT_MAX_REQUESTS=8
本次示例以较低推理强度和 8192 最大完成 token 运行。模型能力、端点、会员权益与参数会变化;生产集成应按开放平台规则、成本与稳定性单独评估。
8. 一次真实演示的证据
下列输入可以逐步观察闭环:
现在几点?
计算 10+8
保存一条标题为“学习计划”的笔记,内容是“明天研究 Agent Loop”
读取“学习计划”
/clear
quit
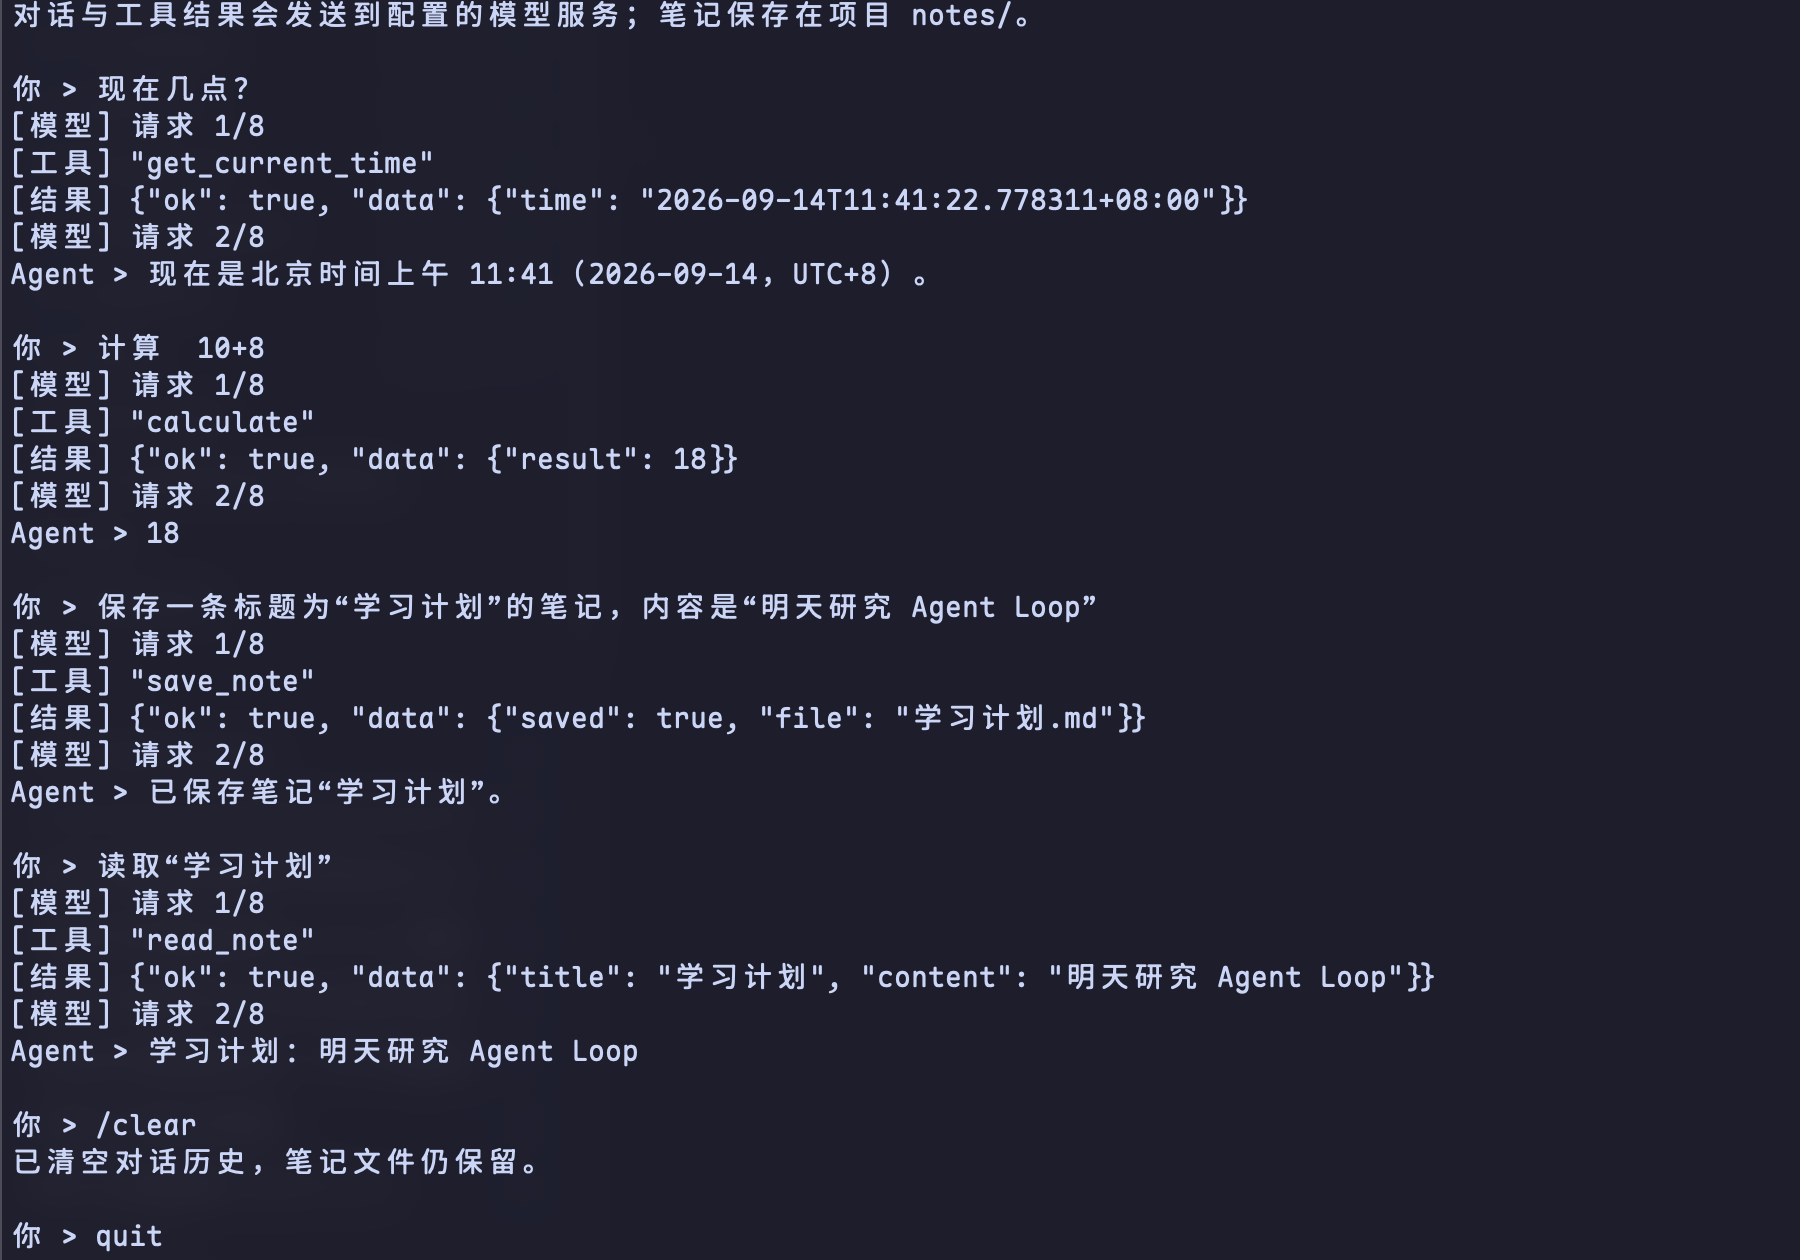
作者在 2026-09-14 的实测中,离线测试通过;真实模型完成了查询时间、计算、保存笔记、读取笔记及后续回忆的闭环。截图中的计算 10+8 得到 18。
演示结果说明的是当时的单次环境与账户能够完成闭环,不代表所有账户都可使用相同配置,也不替代上线前的权限、成本与失败恢复测试。
9. 可复用的方法论
先证明闭环,再增加能力
每个工具都应回答:接受什么输入、允许做什么、如何证明成功、失败怎么处理、能否回滚。先完成一个端到端小任务,再扩展工具与框架。
模型处理不确定性,程序守住确定规则
目标理解与动作选择可交给模型;权限、路径范围、参数类型、请求上限与结果记录由程序执行。不要依赖模型“应该会听话”来保证可靠性。
用执行证据衡量完成
保存文件要检查内容;修改代码要运行适当验证;调用业务接口要检查实际状态。流畅的回答只说明模型生成了文字,不能证明外部动作完成。
自动化以收益为前提
重复出现的工作可先评估自动化,但只有收益明确、输入稳定、风险可控且可回滚时才落地。固定规则优先脚本;确实需要判断与工具选择时再引入 Agent。
10. 学习检查清单
不看框架文档,尝试用自己的话回答:模型返回了什么?谁执行工具?结果如何回到模型?循环何时停止?如果能按伪代码解释完整,就掌握了最小 Agent 的核心。
下一步可以依次练习:为工具增加 JSON Schema 校验;把工具结果写成结构化日志;为单轮请求设置预算;为失败动作补上可回滚设计;最后再考虑摘要、检索和持久化记忆。
来源与延伸阅读
- Kimi Code 文档:订阅端点、模型 ID 与权益说明。
- Kimi K3 接入文档:模型参数与完整消息回传要求。
- OpenAI Function Calling 指南:结构化工具请求与结果关联机制。
- Tech With Tim:Build a Local AI Agent in 10 Minutes:使用 Ollama 与 Pydantic AI 的最小 Agent 教程。
- 小红书:不用框架,从零手搓一个 AI Agent:手写路线的参考;未完整转录或审查视频代码。
本文整理自 2026-09-14 的实践记录,网站整理于 2026-10-04。模型配置保留当时的实测背景;接入前请核对文中官方文档和账户权限。